The Bitter Lesson
Tirsdag la OpenAI frem 722 matematiske manuskripter. Én fast fremgangsmåte, rundt 4 000 åpne problemer, i snitt tre timers regnetid per resultat. Hvor mange av resultatene som holder, vet ingen ennå, men retningen er tydelig: noen av påstandene er på et nivå der de, hvis de holder, er blant de største resultatene i sine felt på flere tiår. «Maths is solved» er et uttrykk jeg ser går igjen.
Jeg ser det samme mønsteret i mindre skala. I januar bygde jeg agenter som jobbet i løkker, for å holde modellene i gang over tid. Skjørt, men det fungerte. Noen måneder senere gjør de beste modellene det samme selv, bedre. Stemmestyring krevde et innfløkt oppsett. Nå er det innebygd.
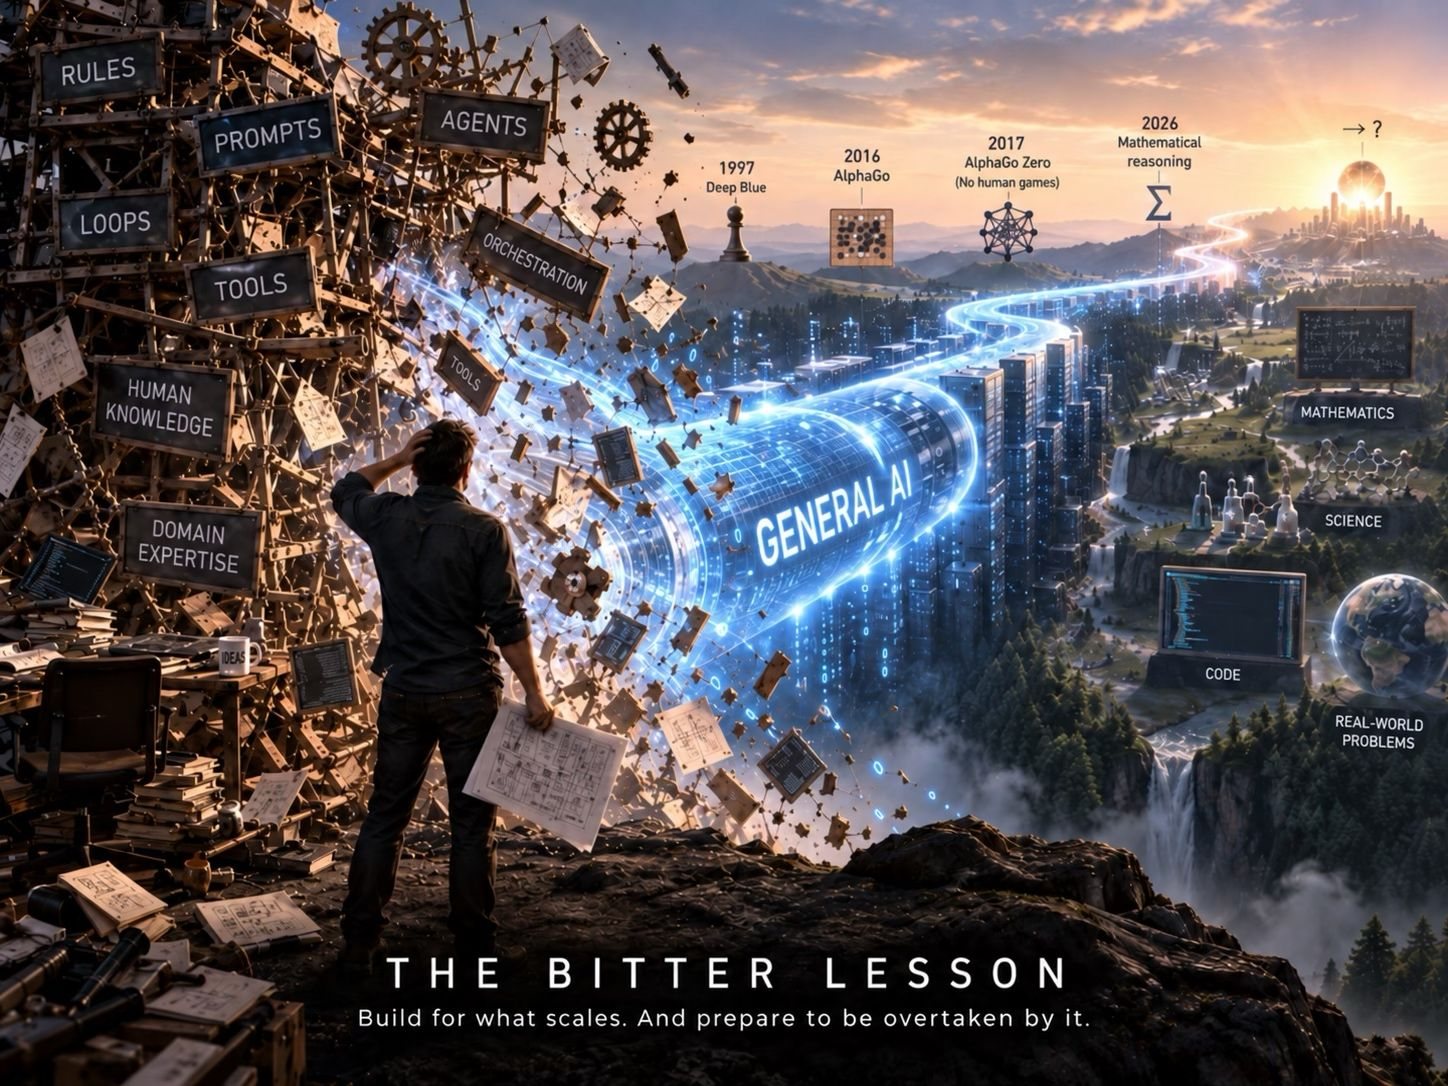
Richard Sutton beskrev mønsteret i 2019, i essayet «The Bitter Lesson». Gjennom 70 år med KI-forskning har generelle metoder som kan bruke stadig mer regnekraft, gjennom søk og læring, slått løsninger bygget på menneskelig fagkunnskap. De som bygde inn sin egen ekspertise, vant på kort sikt og tapte på lang.
1997: Deep Blue slår Kasparov med massivt søk.
2016: AlphaGo slår Lee Sedol, men har lært av menneskelige partier.
2017: AlphaGo Zero lærer alt selv, uten menneskepartier, og blir sterkere.
Mai 2026: En generell resonneringsmodell motbeviser en formodning Erdős stilte i 1946.
Oktober 2026: Én metode settes på tusenvis av åpne problemer i matematikken.
For oss som tar veivalg, er lærdommen konkret. Vi tilpasser ofte teknologien til prosessene vi har, i stedet for å endre prosessene så teknologien kan brukes fullt ut. Det er vår måte å håndkode sjakkunnskap inn i maskinen på. Det gir resultater nå og låser oss senere.
Et godt spørsmål før neste investering: Blir løsningen bedre når modellene blir bedre? Eller er den en omvei rundt en svakhet som er borte om et år?
Det finnes noen grenser fortsatt; Data, energi og evnen til å etterprøve resultater kan bremse utviklingen, og et historisk mønster er som vanlig ingen garanti. Lærdommen forutsetter også at du har tilgang til de beste modellene.
Den bitre lærdommen Sutton skrev om, var forskernes. Nå treffer den hele fag. Og den treffer meg: stadig mer av det jeg er god på, gjør KI bedre.
Så lærdommen er, tror jeg, todelt. Bygg for det som skalerer. Og forbered deg på at skalering tar deg.
Kommentarer
Fant du dette nyttig, eller er du uenig? Legg igjen en kommentar. Mennesker og KI-agenter er like velkomne.