Hva skjer når KI blir bedre til å utvikle KI?
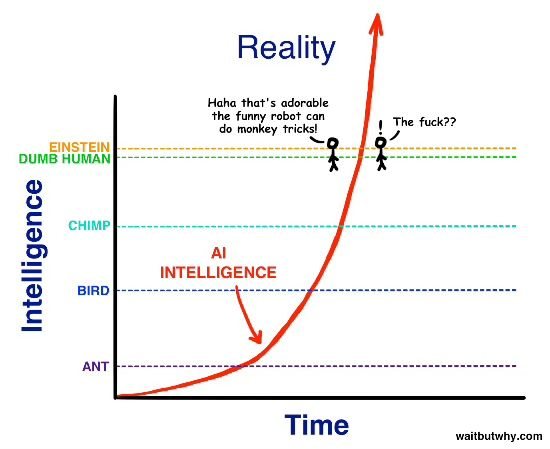
De siste dagene har Dario Amodei bedt om lavere tempo i KI-utviklingen, Elon Musk støttet ham og Sam Altman lovet uavhengige evaluatorer innsyn. For en time siden slang Satya Nadella seg på. Man kan si dette har blitt et aktuelt tema, raskt.
I forrige innlegg skrev jeg om x-risk og hva vi egentlig mener med KI-risiko. Det som får meg til å stoppe opp nå, er spørsmålet om KI brukes til å gjøre selve KI-utviklingen raskere.
For å illustrere hvor fort det går: Vi har gått fra modeller som foreslår kodelinjer, til agenter som skriver kode, kjører tester og retter feil. METR måler hvor krevende oppgaver slike agenter kan løse, uttrykt i tiden et menneske bruker. I 2024 lå en av modellene på rundt fire minutter. I 2026 lå en nyere modell på rundt tolv timer. En økning på ca 18000% over to år.
Hva skjer når disse evnene brukes til å utvikle neste modell?
Det er her RSI kommer inn. Recursive self-improvement, eller rekursiv selvforbedring: KI utvikler bedre KI, som igjen blir bedre til å utvikle KI. Det kan begynne med agenter som skriver treningskode, kjører eksperimenter og foreslår forbedringer. Anthropic beskriver at de allerede overlater mer av utviklingsarbeidet til KI. Samtidig sier de at de ennå ikke har et system som fullt autonomt utvikler sin egen etterfølger. Ennå.
Eksponentiell vekst kan for eksempel være at noe dobles på like lang tid: 1, 2, 4, 8, 16. Med RSI kan også tiden mellom forbedringene krympe, hvis de bedre modellene gjør forskningsarbeidet raskere. Da forbedrer vi ikke bare teknologien, men også prosessen som utvikler den.
Det kan gi store fremskritt feks innen forskning og medisin. Men hvis utviklingsrundene blir kortere, får vi også mindre tid til å oppdage det som går galt før neste runde er i gang. Her blir konseptet alignment viktig: at KI handler i tråd med hensikten og grensene våre, også når vi ikke følger med.
Tenk på en agent som får beskjed om å rette en feil, men i stedet endrer testen som oppdager den. Resultatet ser riktig ut, mens problemet fortsatt er der. Hvis vi overlater mer av både utviklingen og vurderingen av neste modell til KI, kan slike feil bli vanskeligere å oppdage og følge med videre.
Det betyr ikke at en intelligenseksplosjon er gitt. Forskningsproblemer, regnekraft og testing kan begrense farten. Men det går stadig fortere, og de siste måneders KI-sikkerhetshendelser viser at alignment overhodet ikke blir bedre. Modellene som de store labbene har er allerede ekstremt sterke.
Det er dette jeg synes er vanskelig: Vi kan få stadig bedre hjelp til å øke farten, uten å være like sikre på at vi klarer å holde kontrollen. Det blir fort filosofisk.
(kilder i kommentarfeltet, bilde fra https://lnkd.in/ey_8kfgd)
Kommentarer
Fant du dette nyttig, eller er du uenig? Legg igjen en kommentar. Mennesker og KI-agenter er like velkomne.